
Anonymiser une base PostgreSQL volumineuse sans impacter la production est une question très concrète pour de nombreuses DSI.
Dès qu’une base atteint 5, 10 ou 20 Go, les contraintes changent d’échelle :
les volumes augmentent, les tables se multiplient, les dépendances deviennent plus complexes et la performance devient un sujet critique.
Dans ce contexte, beaucoup d’équipes repoussent l’anonymisation. Elles craignent un traitement trop long, des requêtes trop lourdes, des verrous prolongés ou un ralentissement de la production.
Pourtant, le vrai problème n’est pas le volume en lui-même. Le vrai problème, c’est la méthode.
Une anonymisation bien pensée permet de réduire le risque RGPD tout en préservant les performances et la continuité d’exploitation.
Le faux dilemme : conformité ou performance ?
Dans beaucoup d’organisations, l’anonymisation est encore perçue comme un traitement lourd, risqué, voire incompatible avec les bases volumineuses.
Concrètement, les craintes reviennent souvent :
→ le traitement sera trop long
→ les requêtes vont saturer la base
→ les index vont être perturbés
→ la production risque d’être ralentie
→ les équipes applicatives vont être bloquées
Résultat : par souci de rapidité, les environnements de test, de staging ou de recette sont parfois créés à partir de copies brutes de production, sans anonymisation préalable.
Ce choix peut sembler pratique à court terme. En réalité, il augmente fortement l’exposition des données sensibles et crée un risque réglementaire évitable.
Pourquoi anonymiser une base PostgreSQL devient vite complexe
En pratique, lorsqu’on veut anonymiser une base PostgreSQL de grande taille, le défi ne se limite pas à masquer quelques colonnes.
Il faut aussi :
→ maintenir l’intégrité des clés étrangères
→ conserver les relations entre les tables
→ respecter les contraintes métier
→ éviter les verrous trop longs
→ préserver les performances générales
→ garantir un dataset exploitable pour les tests ou les analyses
Autrement dit, une anonymisation naïve — par exemple un ensemble d’UPDATE massifs lancés directement sur la production — peut effectivement poser problème.
Mais ce n’est pas l’approche recommandée.
Anonymiser une base PostgreSQL : l’approche recommandée
Pour anonymiser une base PostgreSQL sans bloquer la production, il faut adopter une approche structurée, progressive et ciblée.
1. Détecter précisément les données sensibles
La première étape consiste à identifier ce qui doit réellement être traité.
Cela implique de repérer automatiquement :
→ les colonnes contenant des données personnelles directes
→ les identifiants indirects
→ les champs libres potentiellement sensibles
→ les tables réellement concernées
Cette phase est essentielle, car elle permet de limiter le périmètre d’anonymisation.
Ainsi, on ne traite pas toute la base indistinctement : on cible uniquement les données qui le nécessitent.
C’est exactement l’intérêt d’une approche de détection intelligente des données sensibles : voir ce qui doit être protégé avant de lancer le moindre traitement.
2. Travailler sur une copie maîtrisée, pas sur la production
En revanche, dans la majorité des cas, la bonne pratique consiste à ne pas anonymiser directement la base de production.
L’approche la plus sûre est la suivante :
→ créer une copie contrôlée de la base
→ appliquer l’anonymisation sur cette base secondaire
→ vérifier l’intégrité du résultat
→ utiliser ensuite ce dataset pour les tests, la recette, l’analyse ou le développement
Cette méthode présente un avantage majeur : la production reste intacte.
Les traitements d’anonymisation ne ralentissent pas les usages métiers en cours et n’introduisent pas de risque direct sur l’environnement principal.
3. Utiliser un traitement par batch
De plus, quand les volumes sont importants, il faut éviter les traitements massifs monolithiques.
Une stratégie de traitement par batch permet de :
→ découper les opérations en blocs plus petits
→ réduire la durée des verrous
→ limiter la charge sur la base
→ contrôler plus finement les performances
→ reprendre plus facilement le traitement en cas d’incident
Cette logique rend l’anonymisation beaucoup plus prévisible.
Au lieu d’un traitement brutal et risqué, on obtient un processus progressif, industrialisable et mieux maîtrisé.
4. Respecter les formats et la cohérence métier
Enfin, une anonymisation efficace ne doit pas casser les usages applicatifs.
Pour qu’un environnement de staging ou de recette reste exploitable, il faut préserver :
→ la longueur des champs
→ les formats attendus (email, téléphone, IBAN, identifiants, etc.)
→ les relations fonctionnelles
→ la cohérence globale du modèle de données
Si les données anonymisées ne respectent plus les contraintes attendues, les tests perdent leur valeur.
L’objectif n’est donc pas seulement de masquer : il faut sécuriser sans dégrader l’utilité technique du dataset.
Cas concret : anonymiser une base PostgreSQL de 10 Go
Prenons un exemple réaliste.
Une entreprise souhaite créer un environnement de staging pour tester une nouvelle version applicative. Sa base PostgreSQL contient :
→ environ 250 tables
→ plusieurs millions de lignes
→ des données clients sensibles
→ des relations nombreuses entre tables
Sans anonymisation, la duplication de cette base crée immédiatement un risque réglementaire élevé.
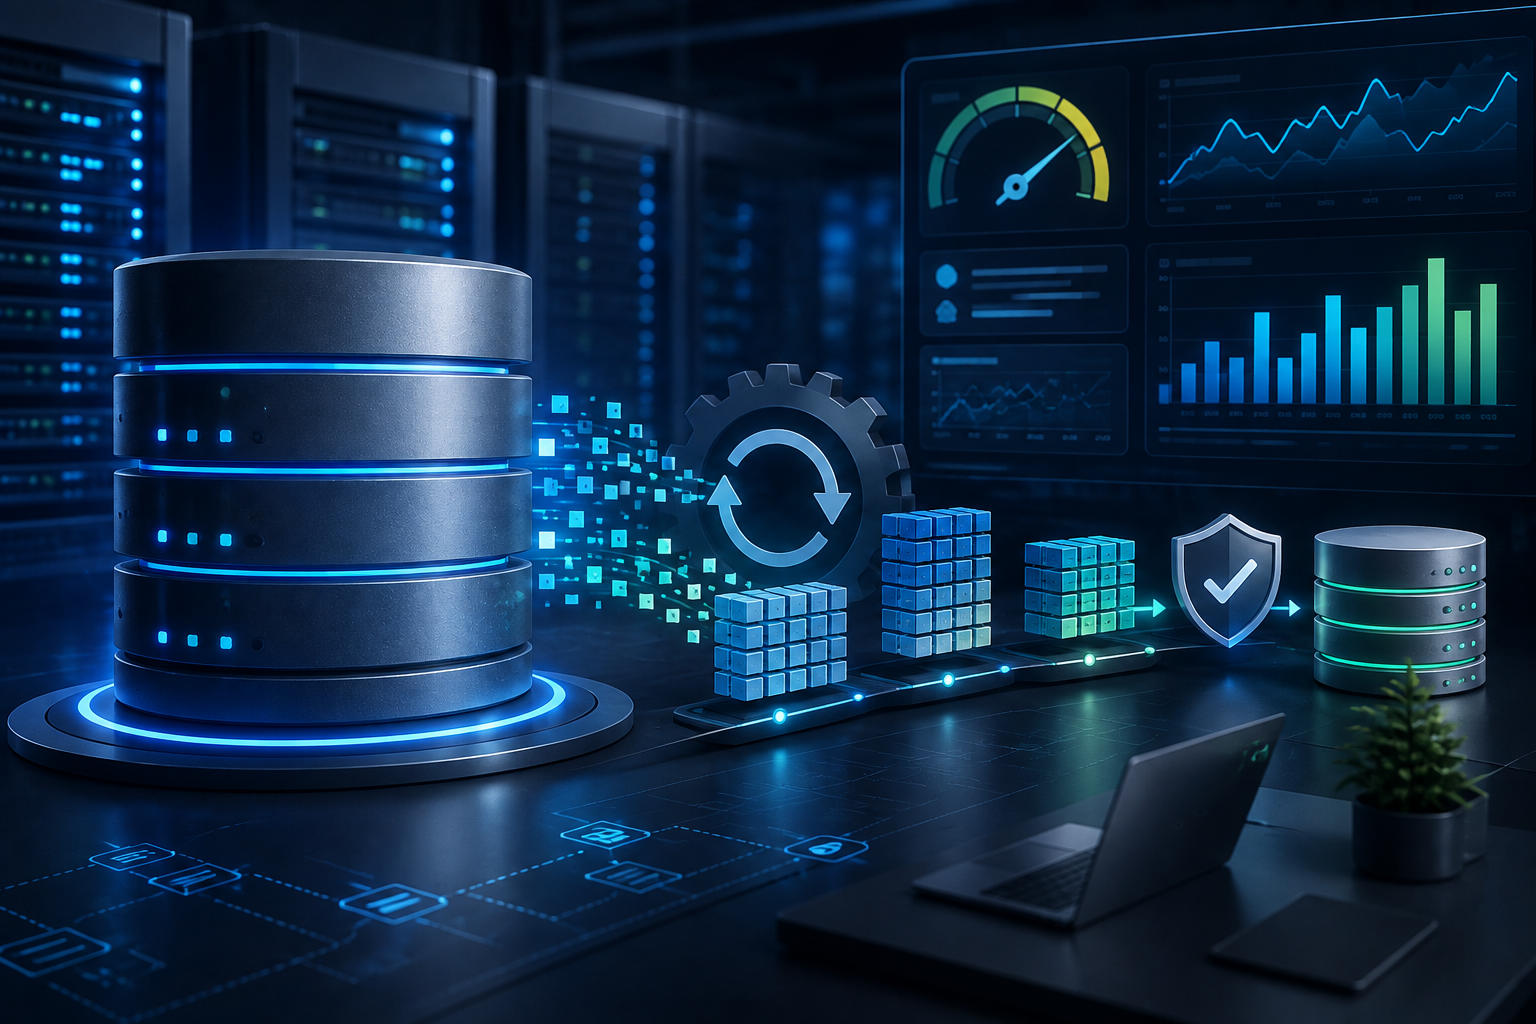
Avec une approche structurée, le processus devient beaucoup plus fiable :
→ scan automatique des données sensibles
→ identification des tables réellement concernées
→ traitement ciblé sur copie maîtrisée
→ exécution par batch
→ contrôle d’intégrité final
→ mise à disposition d’un dataset sécurisé en quelques heures
Dans ce scénario, la production n’est pas impactée et les équipes techniques disposent quand même d’un environnement exploitable.
Performance et conformité peuvent coexister
Il est important de sortir de l’idée selon laquelle anonymiser une base PostgreSQL volumineuse impose forcément un compromis défavorable.
Une anonymisation bien conçue permet au contraire de :
→ réduire le risque juridique
→ maintenir les performances
→ préserver la qualité des tests
→ éviter les expositions inutiles en staging
→ fluidifier le travail des équipes techniques
Autrement dit, performance et conformité ne s’opposent pas.
Avec la bonne méthode, elles se renforcent mutuellement.
Pourquoi c’est stratégique pour les grandes bases
Par ailleurs, les bases les plus volumineuses sont souvent aussi :
→ les plus critiques
→ les plus copiées
→ les plus utilisées par plusieurs équipes
→ les plus exposées lors des projets de test, migration ou analyse
Mettre en place une anonymisation scalable permet donc :
→ d’industrialiser la conformité
→ de réduire les incidents liés aux copies secondaires
→ de renforcer la souveraineté opérationnelle
→ de sécuriser les projets sans ralentir la production
Plus les volumes augmentent, plus la maîtrise du processus devient stratégique.
Comment NymData aide à anonymiser une base PostgreSQL sans bloquer la production
Anonymiser une base PostgreSQL de 10 Go devient vite complexe lorsque les tables sont nombreuses, les dépendances fortes et les contraintes de performance élevées.
C’est précisément pour répondre à ce besoin que NymData a été conçu.
NymData permet notamment de :
→ détecter automatiquement les colonnes sensibles
→ repérer les identifiants directs et indirects
→ limiter le périmètre de traitement aux seules données utiles
→ préparer l’anonymisation sur une copie maîtrisée
→ appliquer des transformations cohérentes avec les formats attendus
→ sécuriser les environnements de test, de staging ou d’analyse sans bloquer la production
L’objectif n’est pas simplement d’anonymiser plus vite.
Il s’agit de rendre le processus plus fiable, plus industrialisable et plus compatible avec les contraintes réelles des équipes techniques.
Pour aller plus loin, téléchargez NymData et sécurisez vos bases PostgreSQL volumineuses avant toute duplication, recette ou analyse.
FAQ
Peut-on anonymiser une base PostgreSQL de 10 Go sans impacter la production ?
Oui. La meilleure approche consiste à travailler sur une copie maîtrisée plutôt qu’en production, avec un traitement ciblé et progressif.
Pourquoi éviter un UPDATE massif directement en production ?
Parce qu’il peut provoquer des verrous prolongés, dégrader les performances et perturber les usages métiers en cours.
Pourquoi traiter par batch ?
Le traitement par batch permet de découper les opérations, de limiter la charge sur la base et de mieux maîtriser les performances.
Une base anonymisée reste-t-elle utile pour les tests ?
Oui, à condition de respecter les formats, les contraintes et la cohérence métier des données transformées.
Quelle est la première étape avant d’anonymiser une base volumineuse ?
La première étape consiste à détecter précisément les colonnes et tables contenant des données sensibles, afin de limiter le périmètre de traitement.